Profil & ramalanProfiling & prediction
Analitik ramalan: pengenalan asas untuk guruPredictive analytics: a basic introduction for teachers
Anda mungkin sudah biasa mengesan murid yang mula tercicir: kerap tidak hadir, lewat menghantar tugasan, markah menurun. Analitik ramalan ialah cara komputer melakukan perkara yang sama untuk ratusan murid sekaligus, dan memberitahu guru siapa yang patut dilihat dahulu.You probably already notice students who are starting to slip: frequent absences, late work, falling marks. Predictive analytics is a way for a computer to do the same across hundreds of students at once, and tell the teacher who to look at first.
FahamiUnderstand
Apa itu analitik ramalan?What is predictive analytics?
Analitik ramalan menggunakan data lepas, seperti kehadiran, markah ujian dan penghantaran tugasan, untuk menganggar kebarangkalian sesuatu berlaku pada masa depan. Dalam pendidikan, soalan biasa ialah: "Adakah murid ini berisiko gagal atau berhenti sekolah?"
Predictive analytics uses past data, such as attendance, test marks and assignment submissions, to estimate the probability of something happening in future. In education, a typical question is: "Is this student at risk of failing or leaving school?"
Perkara paling penting untuk diingat: hasilnya ialah risiko, bukan keputusan. Ia seperti ramalan cuaca. "Hujan 70%" tidak bermakna pasti hujan, tetapi anda tahu bawa payung.
The most important thing to remember: the result is a risk, not a verdict. It is like a weather forecast. "70% chance of rain" does not mean it will rain, but you know to bring an umbrella.
KajiExamine
Bagaimana ia berfungsi, dalam empat langkahHow it works, in four steps
- 1DataDataKehadiran, markah, tugasan, aktiviti dalam talianAttendance, marks, assignments, online activity
- 2ModelModelProgram belajar corak daripada murid terdahuluA program learns patterns from earlier students
- 3RisikoRiskSetiap murid diberi skor atau label seperti rendah/tinggiEach student gets a score or a low/high label
- 4Tindakan guruTeacher actionGuru menyemak dan memberi sokonganThe teacher checks and gives support
Langkah ke-4 ialah yang paling penting, dan ia kerja guru. Model hanya menunjukkan arah. Tanpa guru yang bertanya, berbual dan membantu, skor risiko tidak mengubah apa-apa untuk murid.
Step 4 matters most, and it is the teacher's job. The model only points a direction. Without a teacher who asks, talks and helps, a risk score changes nothing for the student.
Contoh di Malaysia. Pada 30 Julai 2025, Timbalan Menteri Pendidikan Wong Kah Woh memaklumkan Dewan Rakyat bahawa SiPKPM (Sistem Pengesanan Murid KPM) akan disepadukan dengan AI untuk meramal laluan pembelajaran dan kerjaya murid berisiko cicir hingga Tingkatan 5. Dashboardnya mengelaskan murid sebagai berisiko rendah atau tinggi dan menunjukkan trend kehadiran, kemudian sekolah campur tangan kes demi kes (Kosmo, 2025). Ini kenyataan dalam akhbar. Saya tidak menjumpai dokumen rasmi KPM yang menerangkan cara modelnya berfungsi.
A Malaysian example. On 30 July 2025, Deputy Education Minister Wong Kah Woh told the Dewan Rakyat that SiPKPM (KPM's student tracking system) would be integrated with AI to forecast learning and career paths for students at risk of dropping out, up to Form 5. Its dashboard classes students as low or high risk and shows attendance trends, and schools then step in case by case (Kosmo, 2025). This is a statement reported in the press. I could not find an official KPM document explaining how the model works.
ContohExamples
Pendekatan pembelajaran mesin yang paling asasThe most basic machine learning approaches
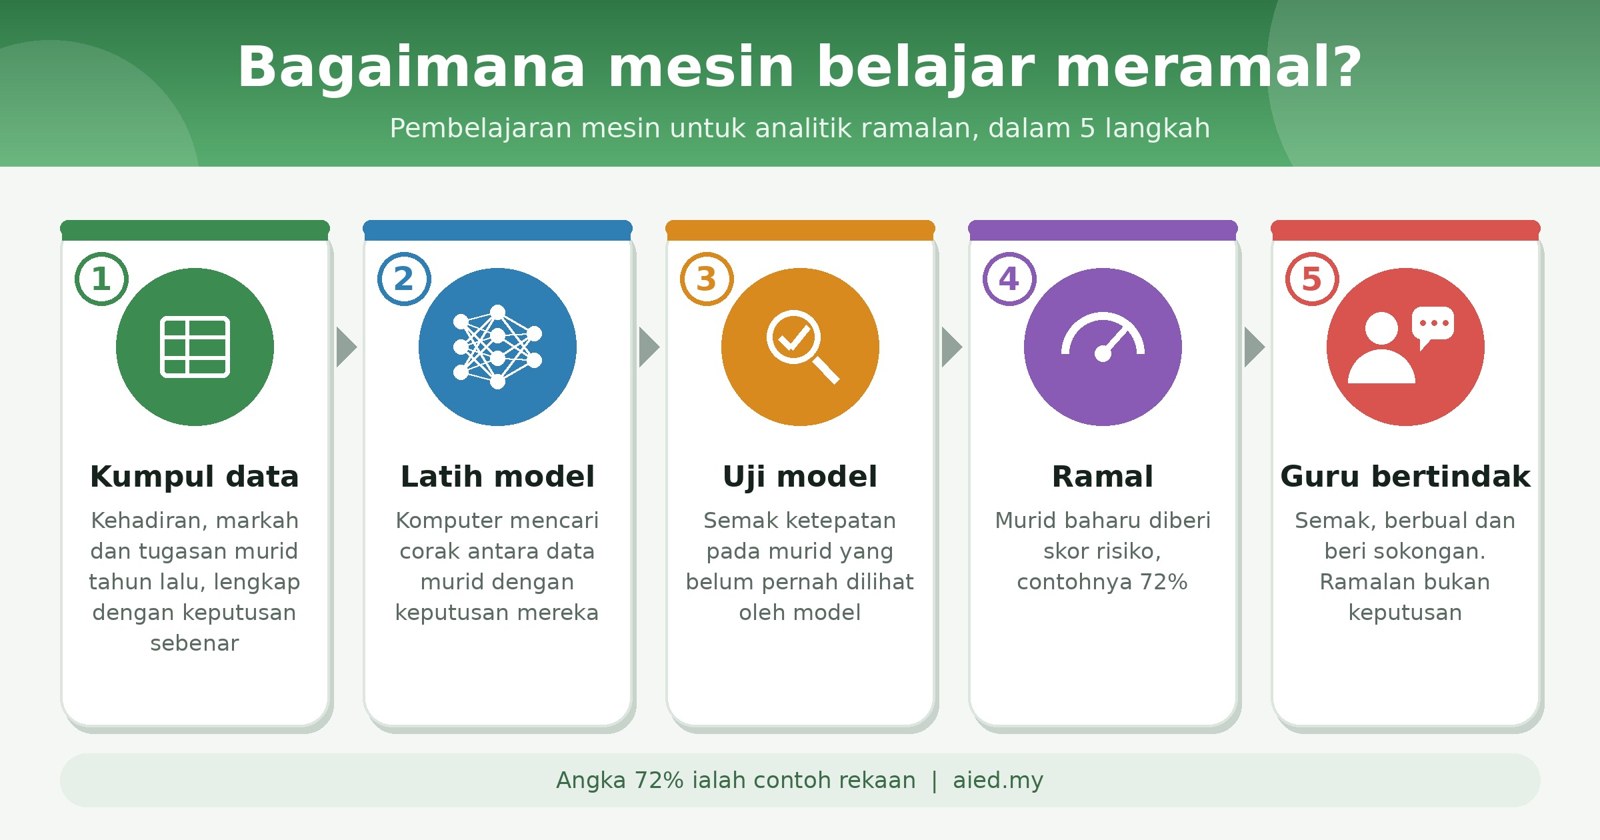
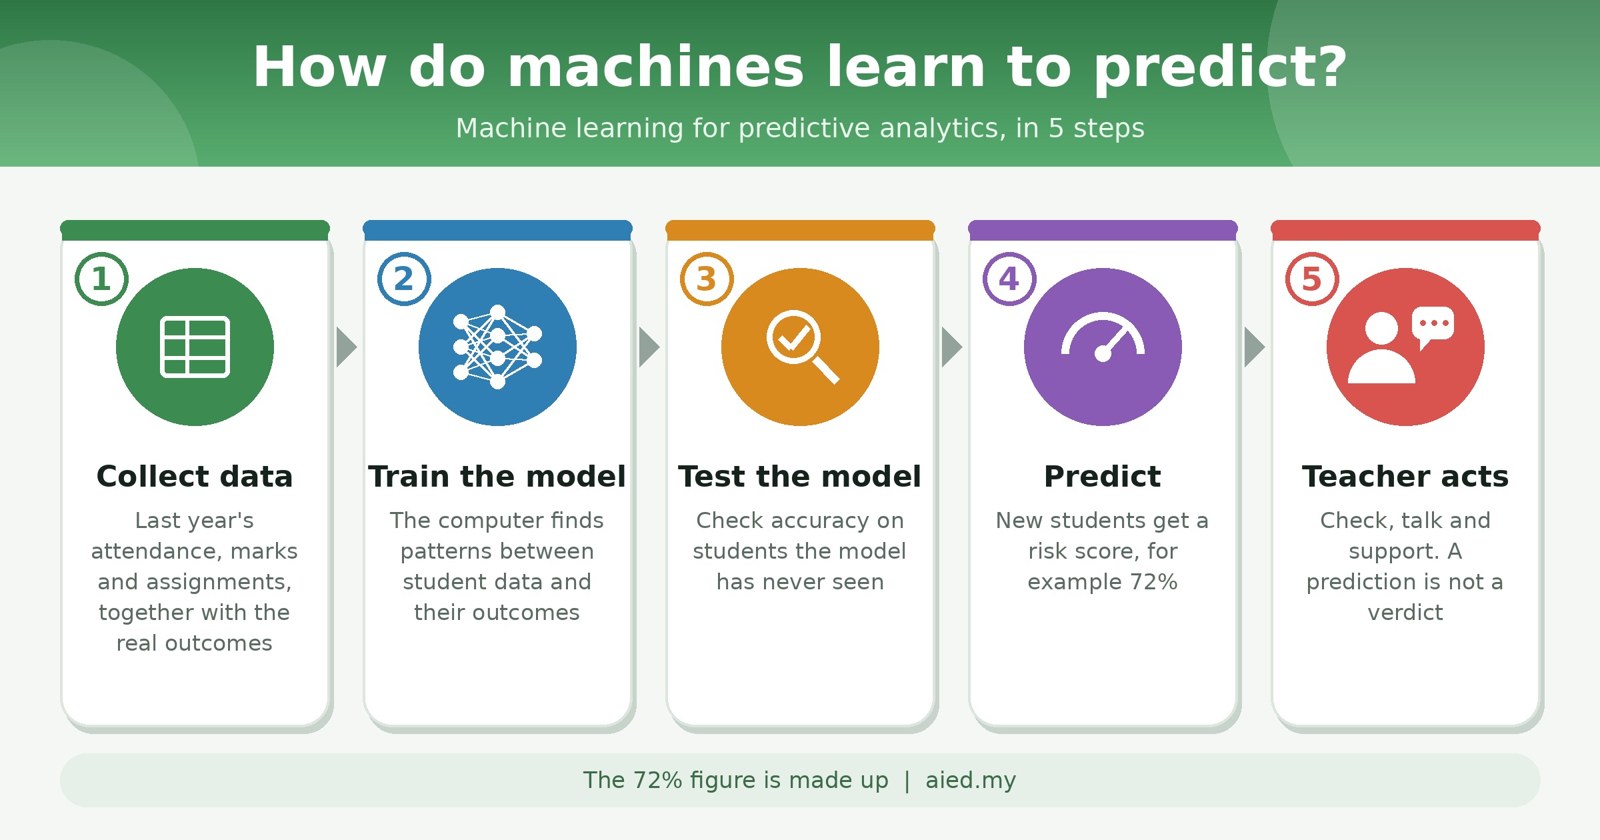
Idea asasnya: kita beri komputer data murid tahun lalu yang keputusannya sudah diketahui (lulus atau gagal). Komputer mencari corak. Kemudian ia menggunakan corak itu untuk menganggar murid tahun ini. Ini dipanggil pembelajaran berpenyelia (supervised learning).
The basic idea: we give the computer last year's student data whose outcomes are already known (passed or failed). The computer looks for patterns, then uses them to estimate this year's students. This is called supervised learning.
Data di bawah ialah contoh rekaan untuk menerangkan konsep sahaja, bukan data sebenar mana-mana sekolah.
The data below is made up to explain the concept only, not real data from any school.
| Murid | Kehadiran % | Tugasan dihantar | Markah ujian 1 | Keputusan akhir |
|---|---|---|---|---|
| A | 95 | 9/10 | 72 | Lulus |
| B | 60 | 3/10 | 35 | Gagal |
| C | 88 | 7/10 | 48 | Lulus |
| D | 70 | 4/10 | 30 | Gagal |
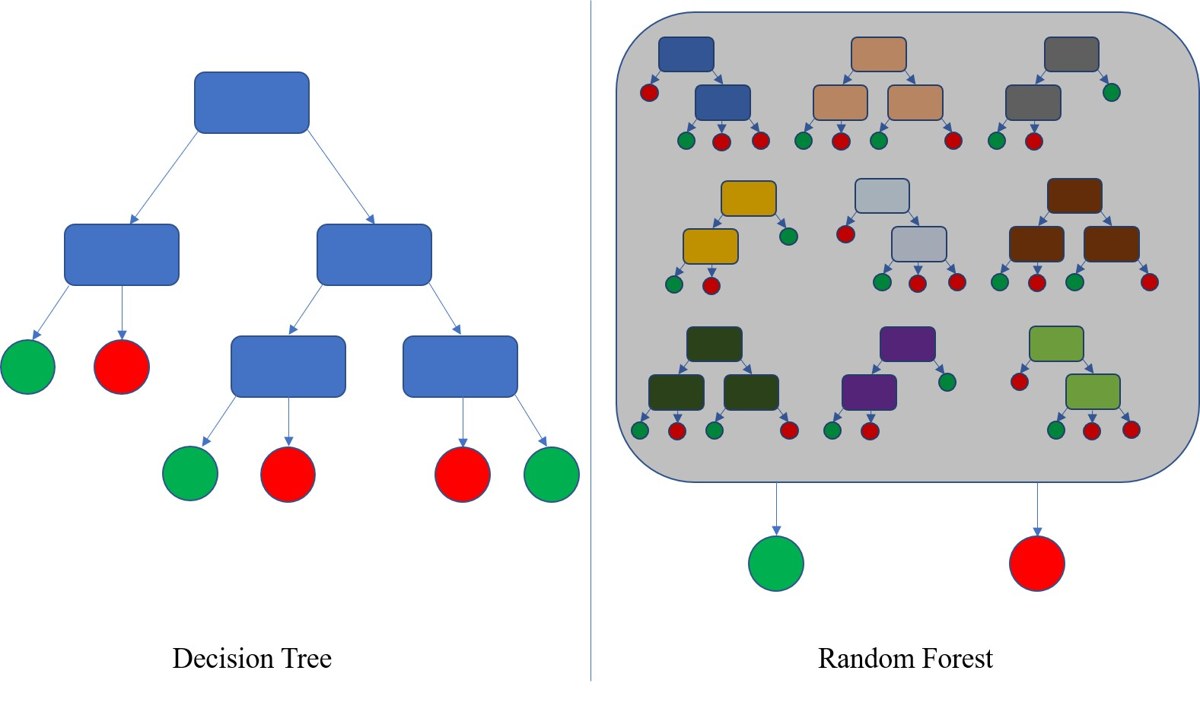
Dua jenis ramalan. Klasifikasi meramal kategori ("lulus" atau "gagal", "risiko rendah" atau "tinggi"). Regresi meramal nombor (contohnya markah akhir sekitar 58). Pokok keputusan dan k-NN boleh digunakan untuk kedua-duanya, manakala regresi logistik digunakan untuk klasifikasi.
Two kinds of prediction. Classification predicts a category ("pass" or "fail", "low" or "high risk"). Regression predicts a number (for example a final mark around 58). Decision trees and k-NN can do both, while logistic regression is used for classification.
Bagaimana tahu model itu baik? Sebahagian data lama disimpan tanpa ditunjukkan kepada model. Selepas belajar, model diuji pada murid yang belum pernah dilihatnya, dan jawapannya dibandingkan dengan keputusan sebenar. Jika ia hanya betul pada data yang sudah dilihat, ia tidak boleh dipercayai untuk murid baharu.
How do we know a model is good? Part of the old data is held back and not shown to the model. After learning, the model is tested on students it has never seen, and its answers are compared with the real outcomes. If it is only right on data it has already seen, it cannot be trusted for new students.
Peringatan: model hanya belajar daripada data yang diberikan. Jika data lama berat sebelah atau tidak lengkap, ramalan juga akan begitu. Itu sebab guru tetap perlu menyemak.
Reminder: a model only learns from the data it is given. If the old data is biased or incomplete, the predictions will be too. That is why teachers still need to check.
KenapaWhy
Kepentingannya kepada guruWhy it matters to teachers
PeringatanCaution
Apa yang perlu diingatWhat to keep in mind
CubaTry it
Lima langkah mudah untuk guruFive simple steps for teachers
- Tanya data apa yang digunakanAsk what data is used
Kehadiran sahaja, atau juga markah dan latar belakang? Siapa yang boleh melihatnya?Attendance only, or also marks and background? Who can see it? - Anggap skor sebagai petunjukTreat the score as a pointer
Sahkan dengan pemerhatian sendiri sebelum bertindak.Confirm with your own observation before acting. - Mulakan dengan berbualStart with a conversation
Tanya murid dan penjaga, kerana punca sebenar selalunya di luar data.Ask the student and guardians; the real cause is often outside the data. - Pilih satu tindakan sokonganChoose one support action
Contohnya bimbingan kecil, rakan sebaya atau mesej kepada penjaga.For example small-group coaching, a peer buddy or a message to guardians. - Semak sama ada ia membantuCheck whether it helped
Jika murid bertambah baik, teruskan. Jika tidak, cuba cara lain dan ingatkan bahawa ramalan boleh salah.If the student improves, continue. If not, try another way, and remember predictions can be wrong.
Artikel ini pengenalan asas. Ikut pekeliling KPM dan arahan sekolah mengenai data murid sebelum menggunakan mana-mana sistem ramalan.This article is a basic introduction. Follow KPM circulars and school rules on student data before using any prediction system.
RujukanSources
- Kosmo! (30 Julai 2025). Berita Dewan Rakyat mengenai SiPKPM dan ramalan murid berisiko cicir. kosmo.com.my
- Karimi-Haghighi, M., Castillo, C., Hernandez-Leo, D. & Moreno Oliver, V. (2021). Predicting Early Dropout: Calibration and Algorithmic Fairness Considerations. arXiv:2103.09068. arxiv.org